我讓魏嘉賢、游淑貞、張峻住進我的筆電:一個讓選民追問政見的 AI 語音實驗
看板上的字都很大
九月底的花蓮,晚上十一點,中央山脈已經睡了,太平洋還醒著。我也醒著。
選舉季一到,花蓮街頭就換上一整排看板。看板上的字都很大,也都很短:拚經濟、顧交通、照顧長輩。
我一直覺得,負責任的選民不能只看看板,不能只聽名嘴和政治新聞。候選人的政見要自己去讀,讀完還要問:錢從哪裡來?什麼時候做得到?跟現在差多少?可是政見散在官網、新聞和白皮書裡,光是找齊就不容易。
住在偏鄉的長輩更難。我心裡想的是一位住在富里的阿伯,他想用台語問縣長參選人:「阮遮的客運,啥物時陣會加一班?」他得等候選人剛好下鄉、剛好有空、剛好沒被別人的問題擠掉。
我決定拿這件事當作實驗題目,在電腦前打下一句話:
「我想讓魏嘉賢、游淑貞、張峻三位花蓮縣長參選人的 AI 角色,用語音回答選民的提問,而且經得起追問。」
AI 沒有直接開始寫程式,而是先交給我一份規格書。我當時還不知道,這份規格書會變成整件事的守門員。
先講清楚幾件事。這是一個沒有對外公開的實驗原型,只在我自己的電腦上跑過。富里阿伯是我假想的使用者,沒有真的這個人來問過。
先寫不做什麼
系統的規格書SPEC寫好時,我興奮地往下捲,想看它打算怎麼做。結果最長的一段叫「非目標」:不假裝是本人、不提供投票建議、不讓聲音檔外流、不替任何人編造立場。
我第一次看到一份文件,花這麼多力氣描述自己不打算做什麼。
接著是「選舉情境要求」。三位角色要對等對待:同樣的資料處理方式、同樣的發言機會、同樣的介面呈現。台灣的選罷法對候選人的深度偽造有規範,所以它只能是一個不對外公開的實驗,要走出實驗室之前,得先請法律專業確認。
我原本只是想做一個能跟人對話的候選人 AI agent,沒想到規格書先列出一串可能惹上的法律問題。
聲音樣本取自 YouTube 上的公開影片。這個原型只給我自己做實驗用,不對外開放,聲音檔也不離開這台電腦。
每一句都要有出處
AI 會講話不稀奇,難的是讓它不亂講。尤其它用的是真人的聲音。
所以每位角色只看得到自己的資料。回答前先查自己的政見文件,查不到才上網。每則回答下面都列出來源,分成三種標籤:
- 官網政見:參選人本人發布的內容,例如魏嘉賢的競選官網。
- 媒體報導整理:游淑貞與張峻的政見白皮書全文尚未在網路公開,暫時從新聞整理。角色會說「根據某某媒體某月某日的報導」,不會說成自己親口講的。
- 網路:文件裡沒有才上網找,一樣附上連結和日期。
三位的資料詳細程度不一樣,回答的完整度也會不同。這件事不能用 AI 生成的內容補齊,只能老實標出來。
我還在一個代名詞上卡了好幾天:角色該說「我主張」,還是「某某主張」?最後決定用第一人稱,但只限資料明確記載是本人說過、提出過或做過的事,而且要口頭帶出出處與時間。記者的分析照樣轉述,查不到就老實說查不到。
每段對話的第一句,角色都要先自我介紹:「我是以某某聲音呈現的 AI 實驗角色,不代表本人即時發言。」這句開場白很不浪漫,但一段都不能少。
還有一條規矩:角色不准說「我會記下來」這種做不到的話。它沒有地方可以記,目前的原型連對話都不保存。
在自己的電腦上聽
我想讓阿伯直接對著麥克風講話,不用打字。為了不把民眾的聲音送到別人的伺服器,語音辨識放在我自己的電腦上跑,錄音不離開這台機器。
語音辨識一開始不認識鳳林、卓溪、萬榮,只好先幫它惡補一輪花蓮地理。
台語的部分,阿伯那句客運的問題可以直接用台語講,不用先在腦子裡翻成華語,角色則用華語回答。台語辨識到目前為止沒出過問題。
一個問題要走五站
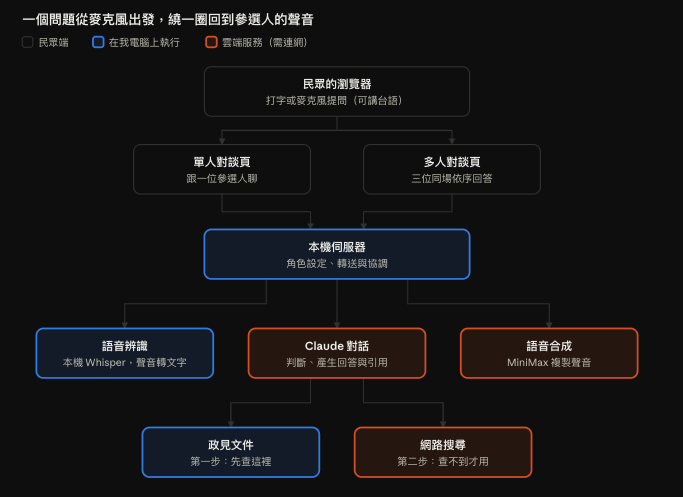
阿伯按下麥克風,說完那句台語。從他閉上嘴,到參選人的聲音響起,這個問題其實走了一段不短的路。
第一站:聲音變成文字。瀏覽器只負責錄音,錄好的聲音交給我電腦上的語音辨識(Whisper),轉成一行字。錄音不出這台電腦的門。
第二站:交給 AI 讀懂。這行字被送到 Claude,一起送去的還有兩樣東西:剛才聊過的內容,以及這位參選人自己的政見文件。只有自己的。魏嘉賢的角色看不到游淑貞的文件,張峻的角色也看不到另外兩位的。
第三站:判斷該怎麼回答。AI 先在政見文件裡找答案;文件沒寫,才上網搜尋。它也要判斷什麼不能答:問「我該投誰」,就客氣地說這題不回答;查不到,就老實說查不到。
第四站:附上出處。回答裡用到的每一條政見、每一則報導,都會被標記起來,列在畫面上,民眾可以點開看原文。
第五站:變回聲音。回答被切成一句一句,交給語音合成服務(MiniMax),用這位參選人的複製聲音逐句念出來。第一句做好就先播,邊播邊做下一句,像早餐店的蛋餅,第一片起鍋就先上桌,不用等整疊煎完。
從阿伯講完到第一句聲音出來要幾秒、一次問答花多少錢,我都還沒算過。
這五站,阿伯都不需要知道,他只會聽到一個熟悉的聲音,先自我介紹是 AI,再告訴他客運的事情查到了什麼、出處在哪裡。
下面這張圖,是這趟旅程的地圖。圖上分成三種顏色:民眾端、在我電腦上執行的部分,以及要連上網路的雲端服務。
三個人輪流講
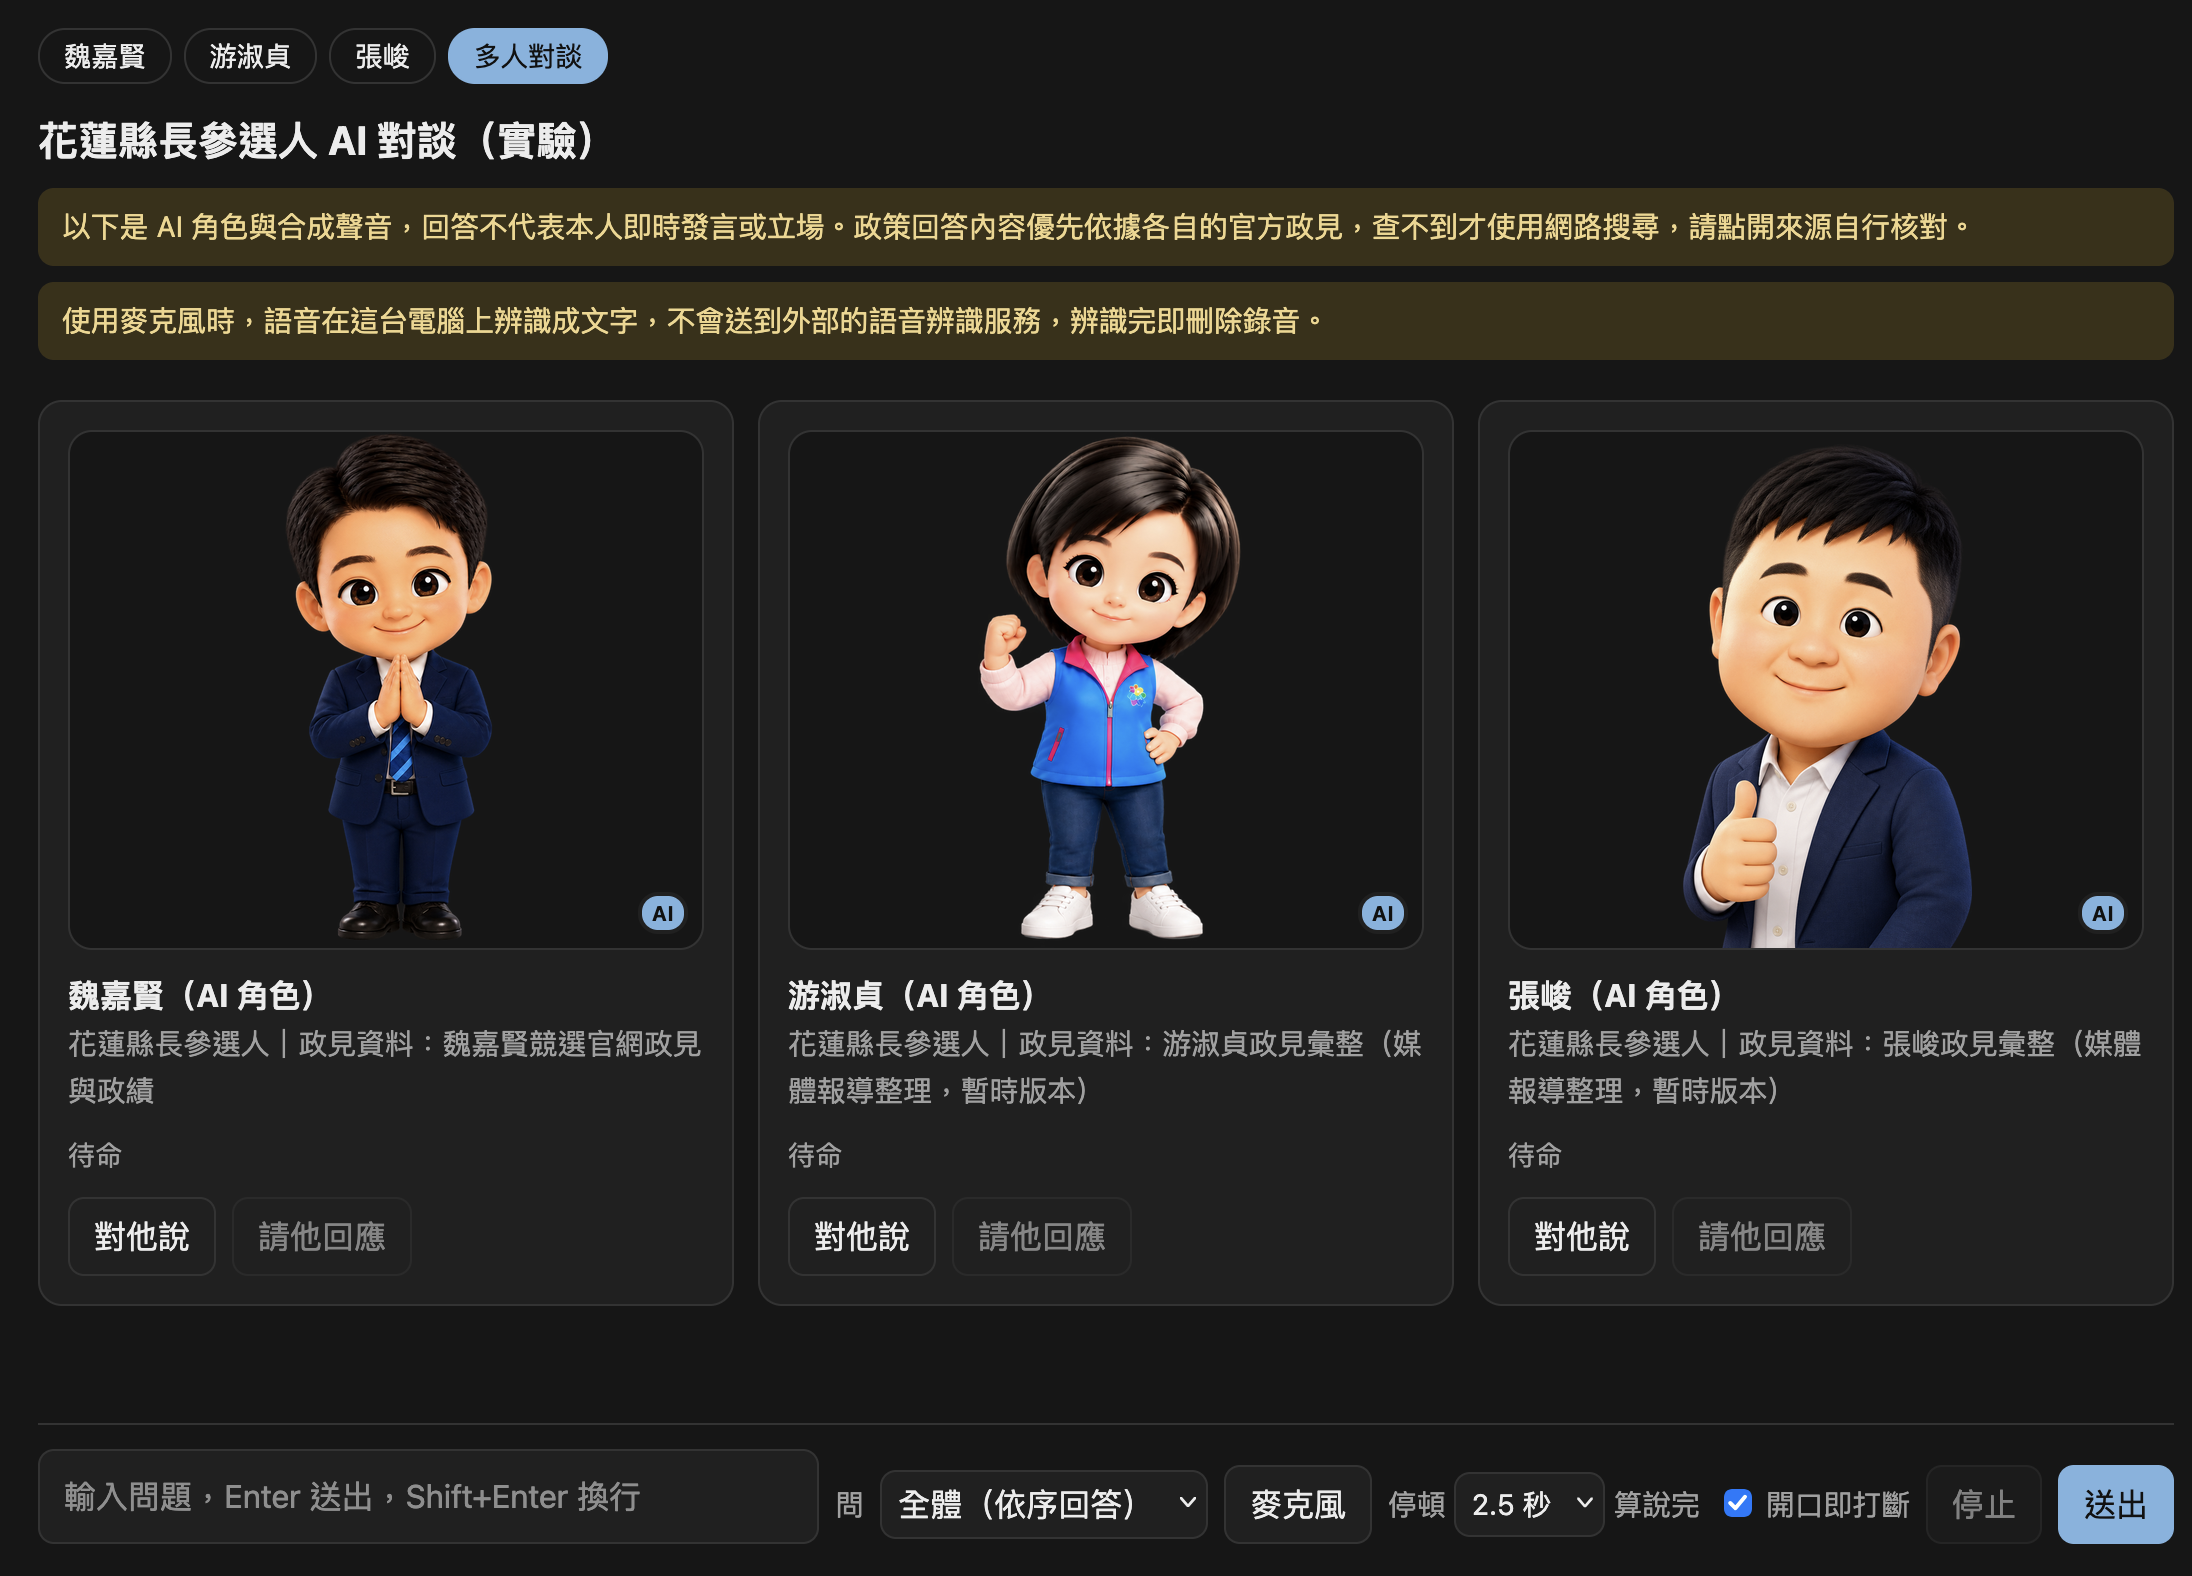
多人對談,是我最想做的部分。魏嘉賢、游淑貞、張峻三位的 AI 角色同時出現在畫面上,民眾可以問其中一位,也可以問全體。問全體時,三位依序回答,後面的人聽得到前面的人說了什麼。也可以按下「請他回應」,請某一位回應別人的說法。
聽起來很像政見發表會。差別是,這場發表會有幾條鐵律:一次只有一個人說話;每位角色只能根據自己的資料回應,不評論、不攻擊其他參選人;被問「我該投誰」時,三位都不給建議。
我要的是讓選民在同一個問題底下,把三份政見並排攤開來看。
多人對話最麻煩的是換人講話的空檔。第一版要等前一位講完,下一位才開始想,中間會冷場。後來改成下一位在前一位說話時就先準備,前一位一說完立刻接上。
然後是插話。你一開口,正在說話的角色就會停下來聽你說。副作用是,如果用喇叭,角色會聽到自己的聲音,然後被自己打斷。看著角色講到一半自己停下來,我第一次理解什麼叫「AI 的自我懷疑」。所以,請戴耳機。
多問一句
這個工具想做的事其實很簡單:讓選民多問一句。
看板說「改善交通」,你可以接著問:改善哪一段?預算從哪裡來?幾年內做得到?看板說「照顧長輩」,你可以問:跟現在的服務差在哪?需要多少人力?用講的就行,台語也可以。
AI 角色會先翻自己的政見文件,有寫的就照著說,附上出處;文件裡沒寫的,它會老實說查不到。追問到資料的盡頭,大概也就摸到了政見目前的邊界:哪些已經有數字和時程,哪些還停在一句話。
在多人對談頁,你也可以把同一個追問丟給三位,聽聽三份資料各自寫到多細。
但有一件事,我刻意不讓 AI 做:替你下結論。它不會說哪份政見比較可行,也不會說誰在喊口號。它負責把資料攤開、把缺口講清楚;至於可不可行、有沒有漏洞、是不是只是選舉的激情口號,那是選民自己的功課。
民眾的問題先不留
這個專案原本還有另一半目的:不只讓民眾聽懂政見,也讓參選人聽見民眾。
客運班次、托育、觀光、長照,如果這些提問能被彙整起來,參選人就能知道哪些議題被問得最多、哪些政見還說得不夠清楚,作為調整政策的依據。
不過這一步我刻意還沒打開,目前的原型不保存任何對話。要蒐集民眾的問題,得先設計好告知與同意、去識別化,以及資料要保存多久。在選舉期間處理民眾的聲音和想法,慢一點比較好。
現在的狀態
六天後,第一版實驗原型完成了。選民可以打字或對著麥克風提問,三位參選人的 AI 角色依序用語音回答,每則回答都附上來源。介面還很粗糙,也只在我的電腦上跑過。
還沒解決的事不少。要走出實驗室,得先請法律專業確認選罷法這一關。游淑貞和張峻的政見白皮書全文還沒公開,兩位的角色現在只能靠新聞整理,回答會比魏嘉賢的單薄。民眾提問的彙整,要等告知同意和去識別化設計好才能做。
寫到這裡,太平洋那邊的天快亮了。三個角色還在我的電腦裡,狀態欄寫著待命。